Meu Portfólio
Dashboards interativos em Power BI e cases de engenharia de dados. Escolha uma aba abaixo e clique em um card para ver os detalhes.
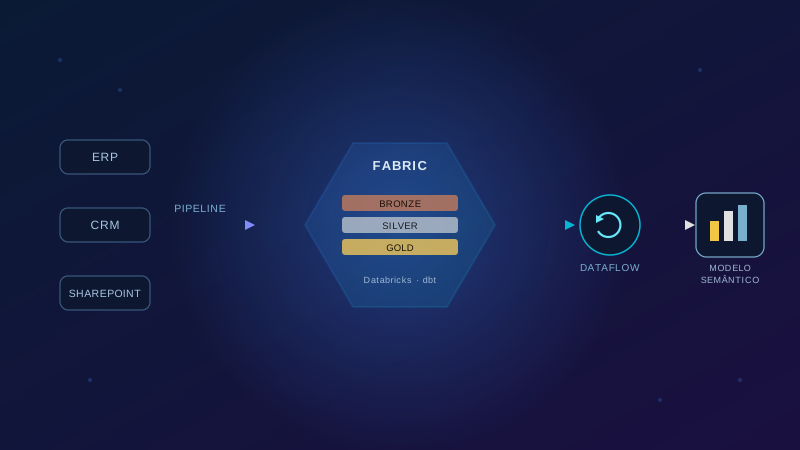
O cliente precisava consolidar dados de múltiplos sistemas de negócio em uma base confiável para BI, reduzindo o retrabalho entre ferramentas de ingestão, processamento e visualização, e com rastreabilidade clara desde a fonte até o indicador final.
- Referência técnica na definição de padrões de engenharia do pipeline, do levantamento de requisitos à entrega final
- Desenvolvimento das camadas Bronze/Silver/Gold com Pipelines do Fabric, Azure Data Factory e Databricks
- Criação de Dataflows para conexão e extração das tabelas do banco de dados do cliente, e modelagem de transformações com dbt
- Desenvolvimento do Modelo Semântico para consumo final dos dados no Power BI
- Validação numérica consultiva dos indicadores entre o banco do cliente e o dashboard
Padronização do fluxo de dados de ponta a ponta, com camadas bem definidas e indicadores validados numericamente entre origem e dashboard — reduzindo divergências e o tempo de investigação de incidentes.
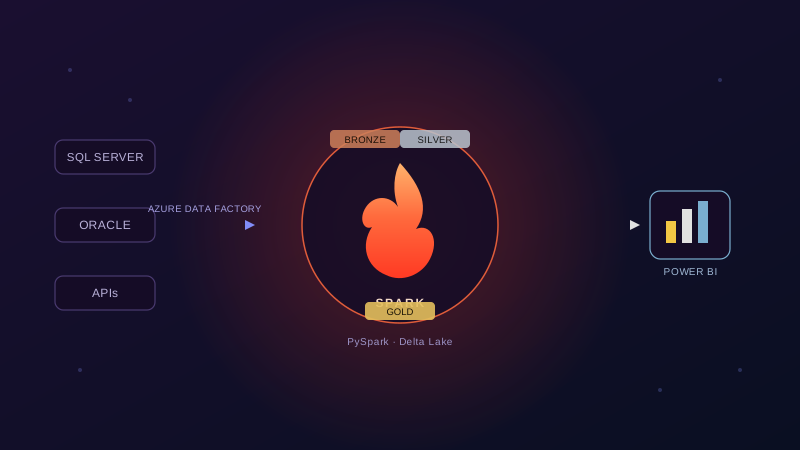
Dados espalhados em bancos relacionais (SQL Server, Oracle) e APIs de terceiros precisavam ser ingeridos, tratados e disponibilizados em escala, com qualidade auditável e baixo custo de manutenção para a equipe.
- Desenvolvimento e manutenção de pipelines com Databricks (Spark/PySpark), orquestrados via Azure Data Factory
- Scripts em Python para integração com APIs e SQL/PL-SQL para modelagem e consultas
- Uso complementar de Pentaho e SSIS para rotinas de ETL
- Orientação a colegas de equipe em boas práticas de SQL/Python e padronização de pipelines
- Desenvolvimento do modelo semântico no Power BI para consumo final dos dados
Pipelines mais resilientes e padronizados, com ingestão e transformação centralizadas em Databricks e orquestração via Azure Data Factory, reduzindo dependência de rotinas manuais de ETL e acelerando a entrega de novas fontes de dados.
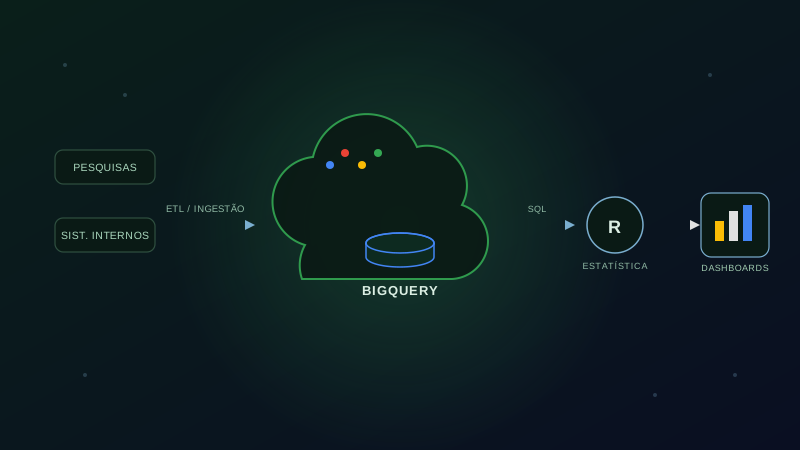
Dados de pesquisas de mercado e de fontes primárias/secundárias precisavam ser centralizados e consultados de forma performática para alimentar relatórios estatísticos e dashboards recorrentes.
- Conexão e manutenção de bases de dados via BigQuery, AWS e GCP
- Modelagem e consultas SQL para consolidar fontes primárias e secundárias
- Geração de relatórios e análises estatísticas com a linguagem R
- Criação e atualização de dashboards de visualização de dados
Centralização das fontes de pesquisa em um data warehouse único, com ganho de performance nas consultas e padronização dos relatórios estatísticos entregues às áreas de negócio.